느린 SQL, AI에게 실행계획을 읽혀봤다 — 15년차 DBA가 검증한 SQL 튜닝 5단계 (Oracle 19c · PostgreSQL 17)
3줄 요약
- AI는 실행계획에서 추정 건수와 실제 건수의 괴리를 찾는 일은 꽤 잘합니다. 단, 실측 계획을 줬을 때만입니다.
AI의 인덱스 제안 중 상당수는 "그럴듯하지만 검증 안 된 가설"입니다. Oracle은 Invisible Index, PostgreSQL은 HypoPG로 만들기 전에 검증합니다.
- Cost만 보고 판단하거나, 운영에서 enable_seqscan = off를 권하는 등 AI가 자주 틀리는 5가지 지점을 정리했습니다.
들어가며
AI × DBA 시리즈 4편입니다. 지난 3편 **「AI에게 내 DB 구조를 이해시키는 법」**에서 스키마 요약과 DDL을 AI에게 전달하는 방법을 정리했습니다. 이번 편부터는 2부 실무로 들어가, DBA가 가장 자주 받는 요청인 **"이 SQL 왜 이렇게 느려요?"**에 AI를 붙여봤습니다.
결론부터 말씀드리면, AI는 실행계획을 **"빨리 읽어주는 동료"**로는 쓸 만했습니다. 하지만 **"최종 판단을 맡길 튜너"**는 아니었습니다. 같은 실행계획을 줘도 무엇을 함께 주느냐에 따라 답의 질이 크게 달라졌고, 틀린 답도 아주 자신 있게 내놓았습니다.
이 글의 SQL과 실행계획은 모두 가상의 테이블(ORDERS, CUSTOMERS)로 만든 설명용 예시이며, 수치도 설명을 위해 단순화했습니다.
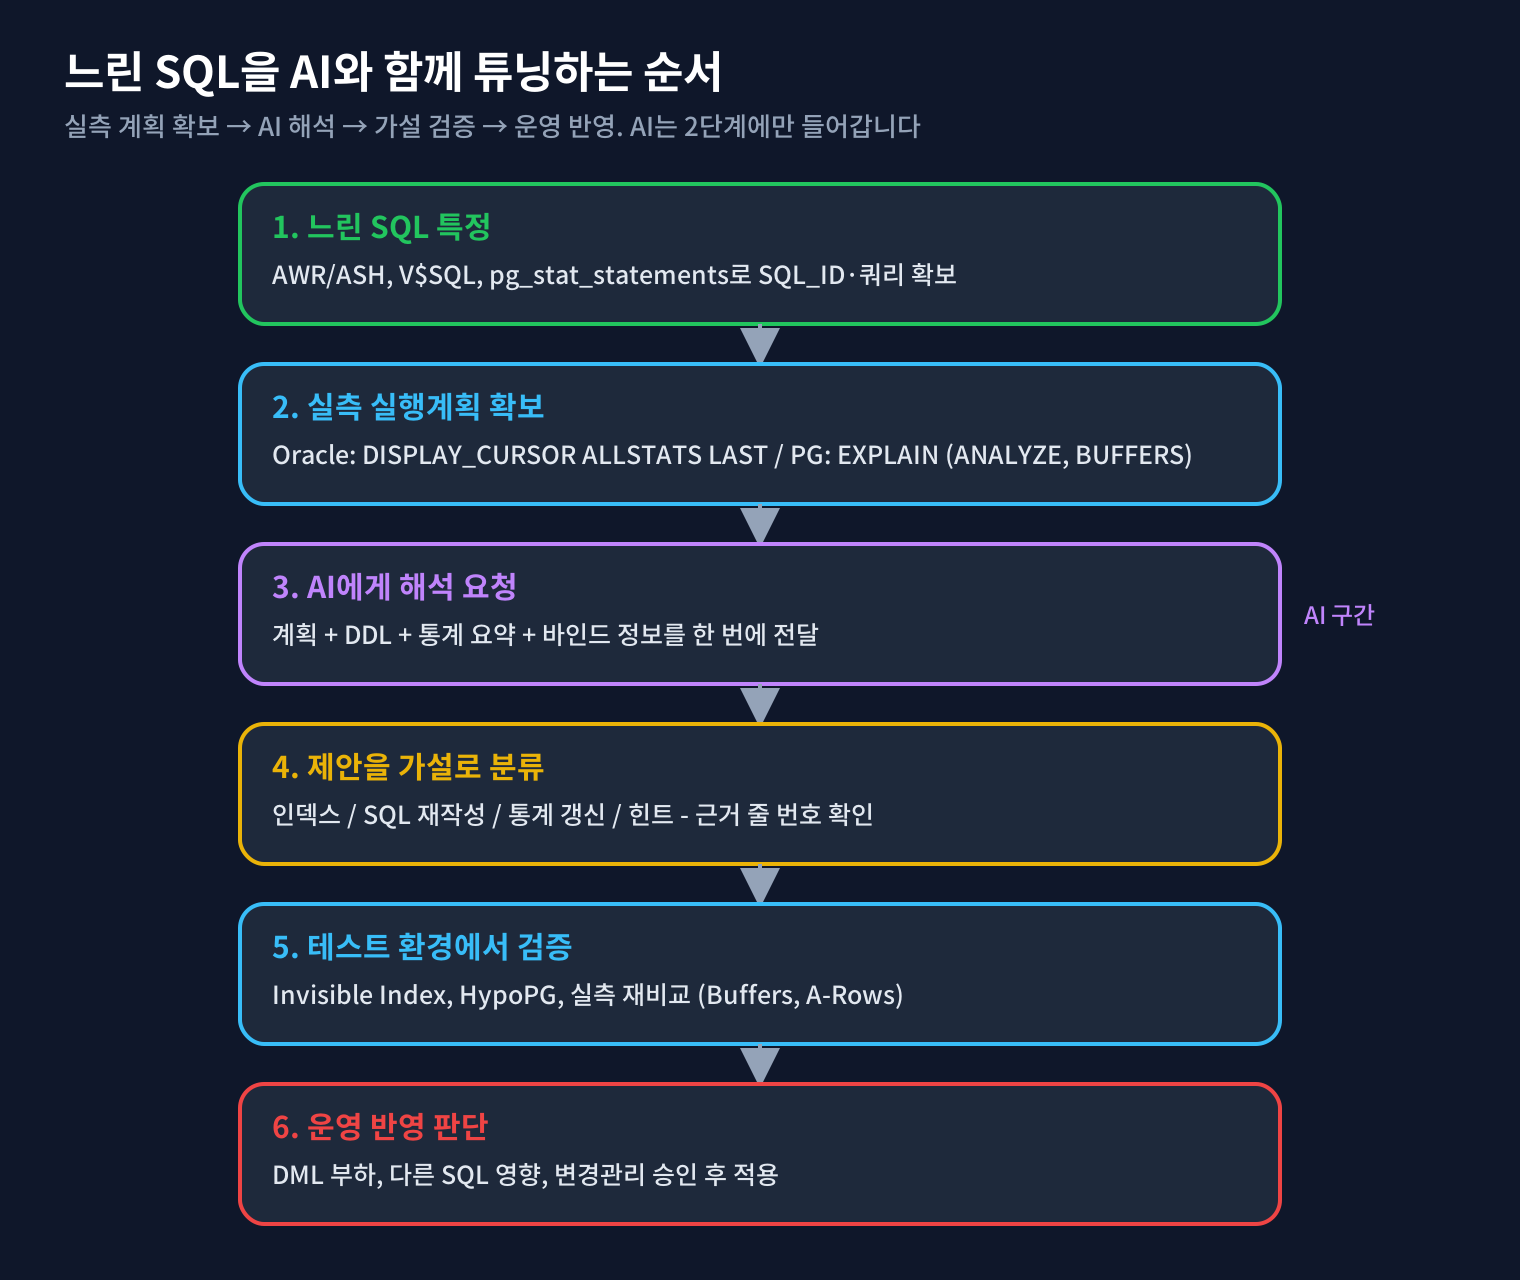
1. AI에게 주기 전에: 반드시 "실측" 실행계획을 확보합니다
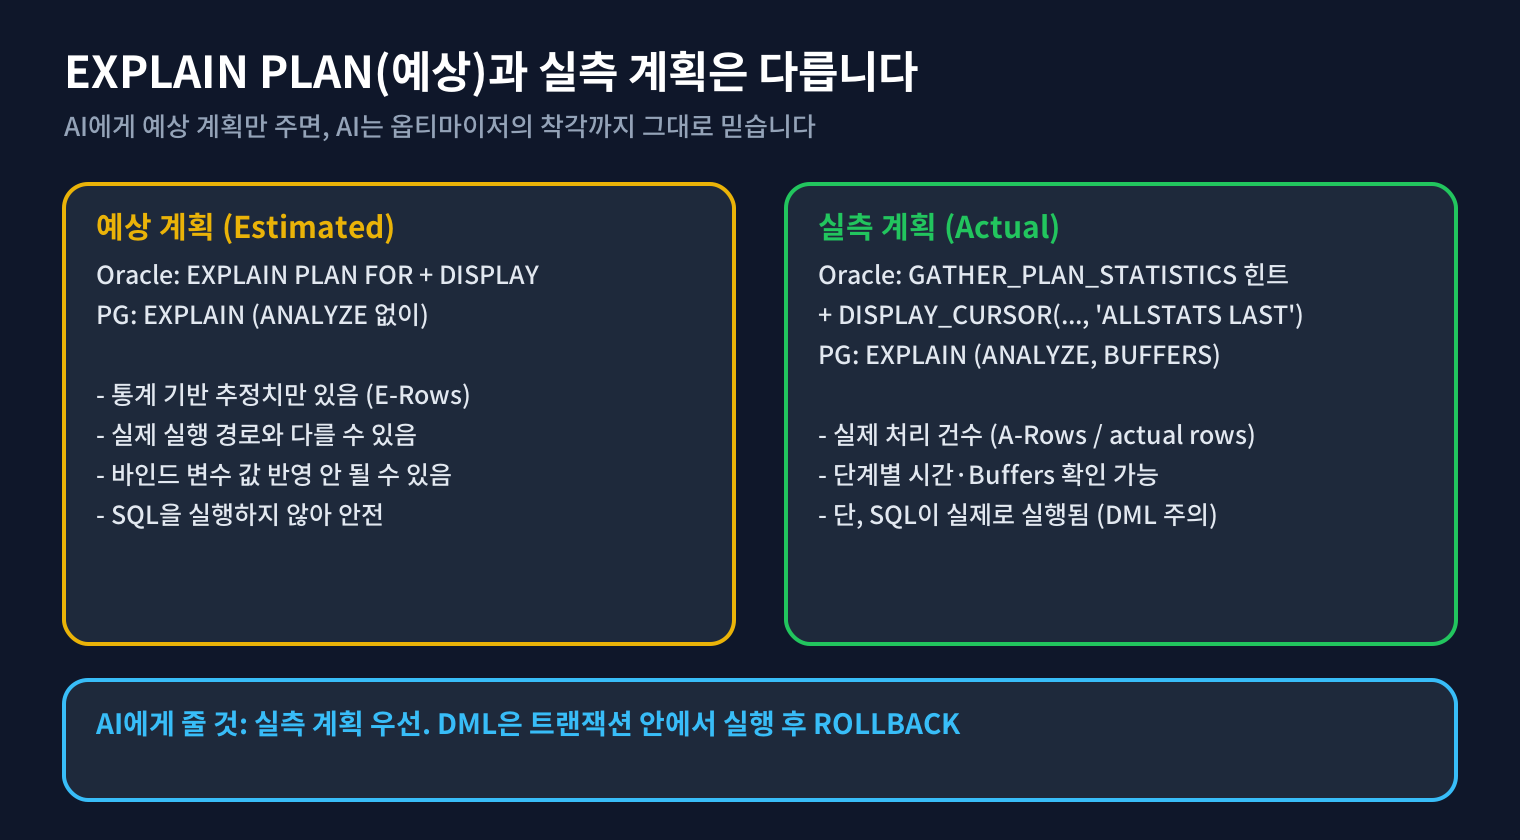
가장 먼저 강조하고 싶은 부분입니다. 실행계획에는 예상 계획과 실측 계획이 있습니다.
| 구분 | Oracle 19c | PostgreSQL 17 | 담긴 정보 |
| 예상 계획 | EXPLAIN PLAN FOR + DBMS_XPLAN.DISPLAY | EXPLAIN | 통계 기반 추정치(E-Rows, Cost) |
| 실측 계획 | GATHER_PLAN_STATISTICS 힌트 + DISPLAY_CURSOR(..., 'ALLSTATS LAST') | EXPLAIN (ANALYZE, BUFFERS) | 실제 건수(A-Rows), 시간, Buffers |
| 주의점 | 예상 계획은 실제 실행 경로와 다를 수 있음 | ANALYZE는 SQL을 실제로 실행함 | DML은 트랜잭션 후 ROLLBACK |
예상 계획만 AI에게 주면, AI는 옵티마이저가 착각한 추정치를 그대로 믿고 분석합니다. 옵티마이저의 착각을 찾는 게 튜닝의 핵심인데, 그 착각을 사실로 받아들이는 셈입니다.
Oracle 19c — 실측 계획 확보
-- SQL*Plus라면 먼저 SET SERVEROUTPUT OFF (안 하면 마지막 SQL이 DBMS_OUTPUT 호출로 잡힘)
SET SERVEROUTPUT OFF

SELECT /*+ GATHER_PLAN_STATISTICS */
       c.cust_name, SUM(o.amount) AS total_amt
  FROM orders o
  JOIN customers c ON c.cust_id = o.cust_id
 WHERE TO_CHAR(o.order_dt, 'YYYYMMDD') >= '20261101'
   AND o.status = 'PENDING'
 GROUP BY c.cust_name;

SELECT *
  FROM TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL, NULL, 'ALLSTATS LAST'));
운영에서 이미 돌고 있는 SQL이라면 SQL_ID를 찾아 DISPLAY_CURSOR('&sql_id', NULL, 'ALLSTATS LAST')로 조회합니다. 다만 STATISTICS_LEVEL이 기본값(TYPICAL)이고 힌트가 없으면 A-Rows 같은 행 단위 통계는 나오지 않습니다.
PostgreSQL 17 — 실측 계획 확보
-- DML이라면 반드시 트랜잭션으로 감싸고 ROLLBACK
BEGIN;
EXPLAIN (ANALYZE, BUFFERS, SERIALIZE, MEMORY)
SELECT c.cust_name, SUM(o.amount) AS total_amt
  FROM orders o
  JOIN customers c ON c.cust_id = o.cust_id
 WHERE to_char(o.order_dt, 'YYYYMMDD') >= '20261101'
   AND o.status = 'PENDING'
 GROUP BY c.cust_name;
ROLLBACK;
PostgreSQL 17부터 EXPLAIN에 SERIALIZE(네트워크 전송용 데이터 변환 시간)와 MEMORY(옵티마이저 메모리 사용량) 옵션이 추가됐습니다. 결과 건수가 많은 SQL에서 "DB는 빠른데 화면은 느리다"는 상황을 구분할 때 유용합니다.
[내부 링크: PostgreSQL 시리즈 — EXPLAIN ANALYZE 실행계획 읽기 편]
2. AI에게 보낸 프롬프트: 계획만 던지면 안 됩니다
처음에는 실행계획만 붙여넣고 "왜 느려?"라고 물었습니다. 답은 "풀스캔이 있으니 인덱스를 만드세요" 수준이었습니다. 그래서 3편에서 정리한 컨텍스트 구성 방식대로 다시 보냈습니다.
[역할] 당신은 Oracle 19c 성능 튜닝을 검토하는 시니어 DBA입니다.
[목표] 아래 SQL이 느린 원인을 실행계획 근거로 설명하고, 개선안을 "가설"로 제시하세요.

[환경]
- Oracle 19c, OLTP, ORDERS 약 1,000만 건(가상), 하루 INSERT 많음
- 이 SQL은 화면에서 하루 수백 회 호출, 바인드 변수 사용(:from_dt, :status)

[DDL 요약]
- ORDERS(order_id PK, cust_id, order_dt DATE, status VARCHAR2(10), amount NUMBER)
- 인덱스: PK_ORDERS(order_id), IX_ORDERS_CUST(cust_id)
- CUSTOMERS(cust_id PK, cust_name ...)

[통계]
- ORDERS LAST_ANALYZED: 40일 전 / STATUS 컬럼 히스토그램: 없음
- STATUS 분포: COMPLETE 95%, PENDING 3%, 기타 2%

[실측 실행계획]  (DISPLAY_CURSOR ALLSTATS LAST 결과 그대로)
...

[요청]
1. E-Rows와 A-Rows 차이가 큰 줄을 Id 번호로 짚고 원인을 추정
2. 개선안마다 근거가 되는 Id 번호, 부작용(DML·다른 SQL 영향), 검증 방법을 함께 제시
3. 확실하지 않은 내용은 "추정"이라고 표시. 운영 DB에서 실행할 명령은 쓰지 말 것
포인트는 세 가지입니다.
| 프롬프트 요소 | 넣었을 때 달라진 점 |
| 통계·데이터 분포 | "인덱스 만드세요" → "히스토그램 부재로 추정이 틀렸다"까지 짚음 |
| 근거 Id 번호 요구 | 계획에 없는 내용을 지어내는 비율이 확연히 줄어듦 |
| "추정" 표시 요구 | 확신과 추측이 구분돼 검증 우선순위를 잡기 쉬움 |
실제 바인드 값이나 고객명 같은 원본 데이터는 붙여넣지 않았습니다. 이 부분은 2편 **「DB 접속 정보를 AI에게 줘도 될까 — 보안 기준 정리」**의 기준을 그대로 따랐습니다.
[내부 링크: Claude 시리즈 — 프롬프트 잘 쓰는 법 편]
3. AI가 잘한 것: 추정과 실측의 괴리를 정확히 짚었습니다
AI에게 준 실측 계획(가상 예시)의 핵심 부분은 아래와 같습니다.
--------------------------------------------------------------------------------------------
| Id  | Operation                     | Name         | Starts | E-Rows | A-Rows |   A-Time   |
--------------------------------------------------------------------------------------------
|   0 | SELECT STATEMENT              |              |      1 |        |    120 |00:00:08.41 |
|   1 |  HASH GROUP BY                |              |      1 |      1 |    120 |00:00:08.41 |
|   2 |   NESTED LOOPS                |              |      1 |      1 |  48000 |00:00:08.12 |
|*  3 |    TABLE ACCESS FULL          | ORDERS       |      1 |      1 |  48000 |00:00:06.90 |
|   4 |    TABLE ACCESS BY INDEX ROWID| CUSTOMERS    |  48000 |      1 |  48000 |00:00:01.10 |
|*  5 |     INDEX UNIQUE SCAN         | PK_CUSTOMERS |  48000 |      1 |  48000 |00:00:00.52 |
--------------------------------------------------------------------------------------------
Predicate Information (identified by operation id):
   3 - filter(("O"."STATUS"='PENDING' AND TO_CHAR("O"."ORDER_DT",'YYYYMMDD')>='20261101'))
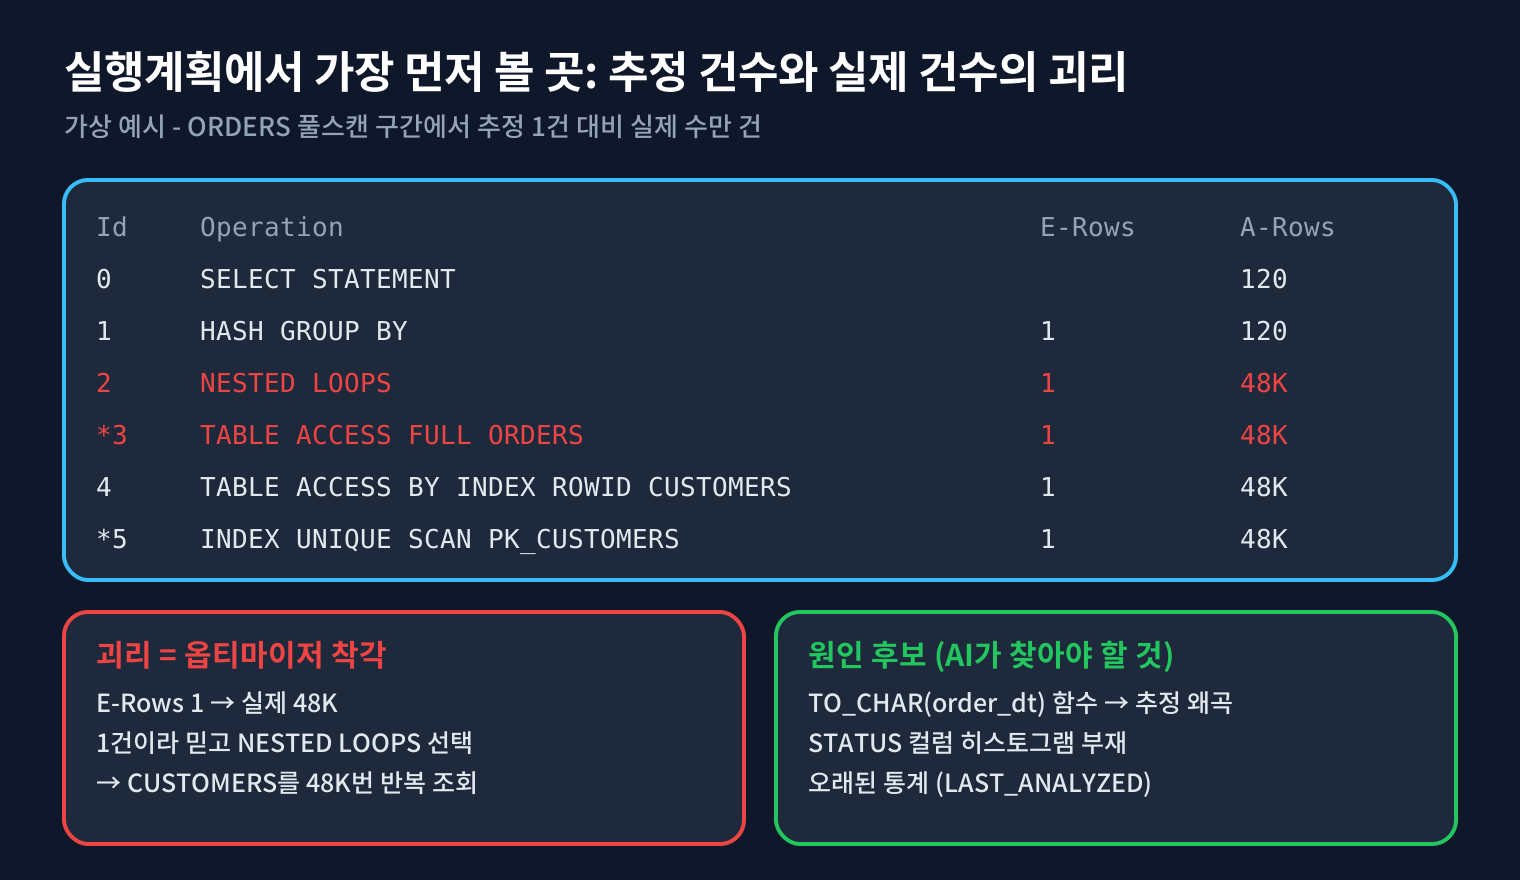
AI의 분석 중 맞았던 부분입니다.
- Id 3에서 E-Rows 1, A-Rows 48,000 — 옵티마이저가 1건이라 믿고 NESTED LOOPS를 골랐고, 그 결과 Id 4·5가 48,000번 반복(Starts) 됐다고 정확히 짚었습니다.
- TO_CHAR(order_dt) 함수 때문에 컬럼 통계를 제대로 활용하지 못해 추정이 왜곡됐고, order_dt 인덱스가 있어도 쓸 수 없다고 설명했습니다.
- STATUS 히스토그램이 없어 3%짜리 값의 선택도를 제대로 추정하지 못했을 가능성을 언급했습니다.
여기까지는 숙련된 DBA가 5분 안에 보는 내용이지만, 주니어에게 설명하거나 새벽 장애 상황에서 1차 정리를 맡기기에는 충분히 쓸 만했습니다.
4. AI가 틀린 것: 검증해보니 이런 지점에서 무너졌습니다
같은 방식으로 Oracle·PostgreSQL SQL 여러 개를 돌려보면서 AI가 반복해서 틀린 지점을 모았습니다.
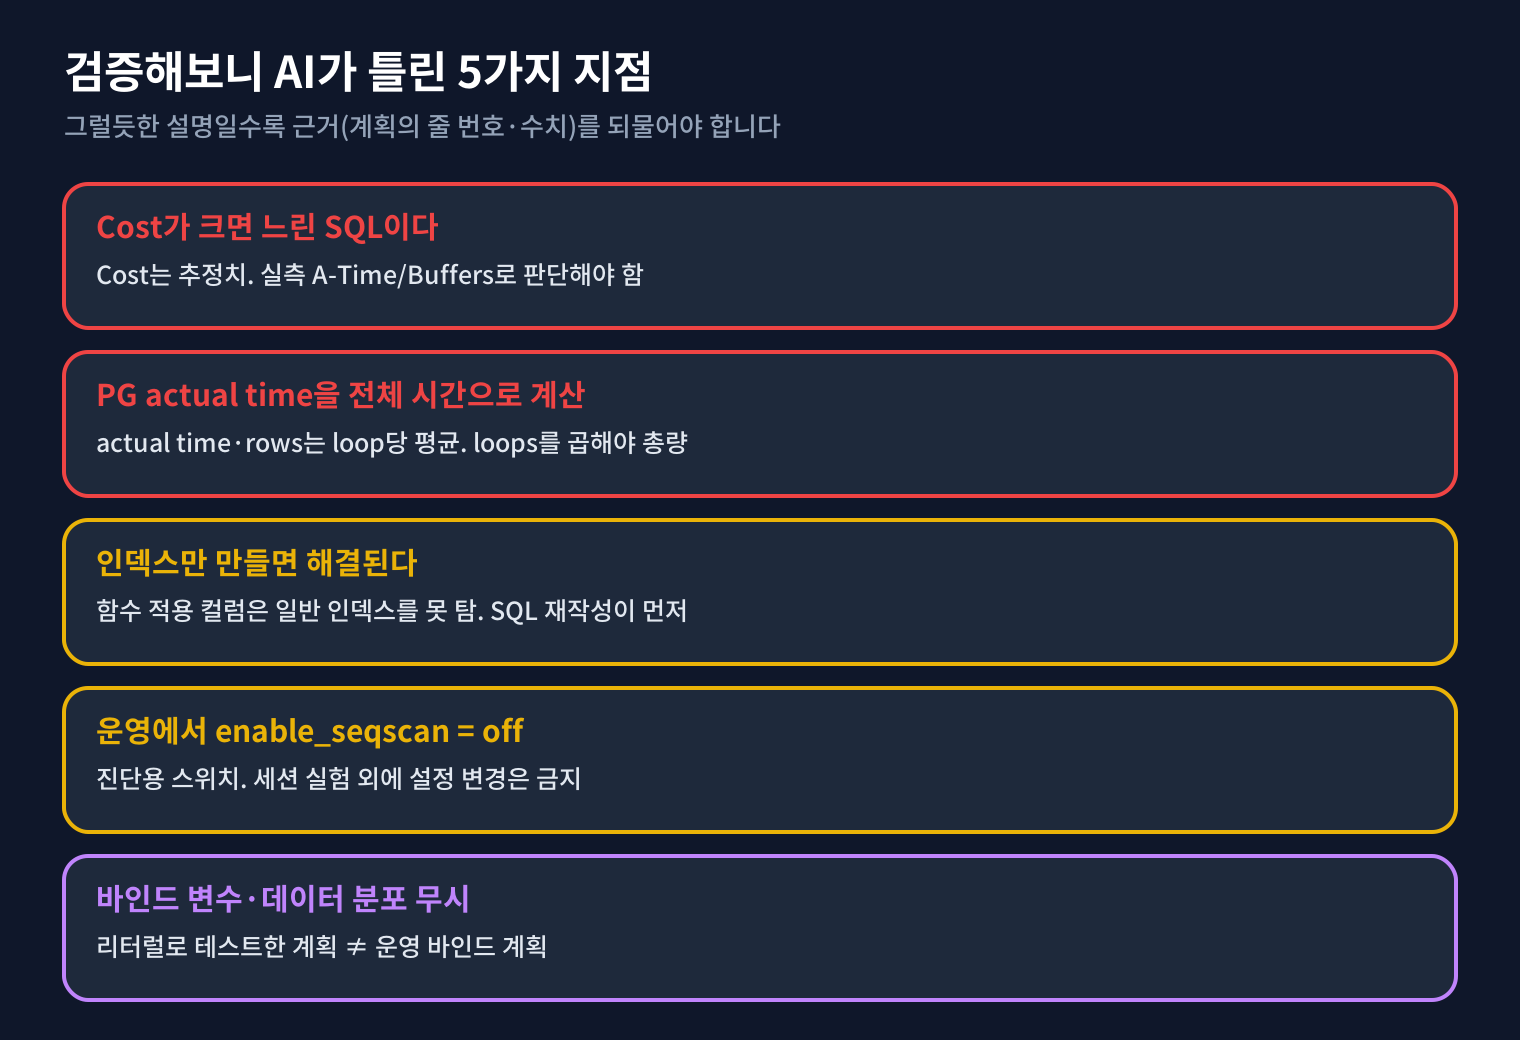
| # AI의 주장 | 실제 | 판단 근거 | |
| 1 | "Cost가 크니 이 단계가 병목입니다" | Cost는 추정치. 추정이 틀린 SQL에서는 Cost도 틀림 | A-Time, Buffers로 판단 |
| 2 | PG actual time을 그대로 합산 | actual time·rows는 loop당 평균. loops를 곱해야 총량 | Nested Loop 안쪽 노드에서 특히 오판 |
| 3 | "(status, order_dt) 인덱스만 만들면 해결" | TO_CHAR 함수가 그대로면 order_dt 범위 조건에 인덱스를 못 씀 | SQL 재작성이 먼저 |
| 4 | PG에서 "enable_seqscan = off로 설정하세요" | 진단용 스위치. 세션 실험 외 서버 설정 변경은 다른 SQL 전체에 영향 | 운영 파라미터 변경 금지 |
| 5 | 리터럴 값으로 분석한 계획을 운영 계획으로 간주 | 운영은 바인드 변수. 바인드 피킹·데이터 분포에 따라 계획이 다름 | 운영 SQL_ID 계획으로 재확인 |
특히 2번은 PostgreSQL 실행계획을 처음 보는 분들도 자주 헷갈리는 부분인데, AI도 똑같이 틀렸습니다. 아래처럼 loops=48000인 노드의 actual time=0.010..0.012는 "총 0.012ms"가 아니라 **"한 번에 약 0.012ms × 48,000번"**입니다.
->  Index Scan using customers_pkey on customers c
      (cost=0.43..8.45 rows=1 width=40)
      (actual time=0.010..0.012 rows=1 loops=48000)
      Buffers: shared hit=192000
3번은 더 위험했습니다. AI가 권한 인덱스를 그대로 만들었다면 인덱스는 생겼지만 SQL은 여전히 풀스캔이고, ORDERS 테이블의 INSERT 비용만 늘어나는 결과가 됐을 것입니다.
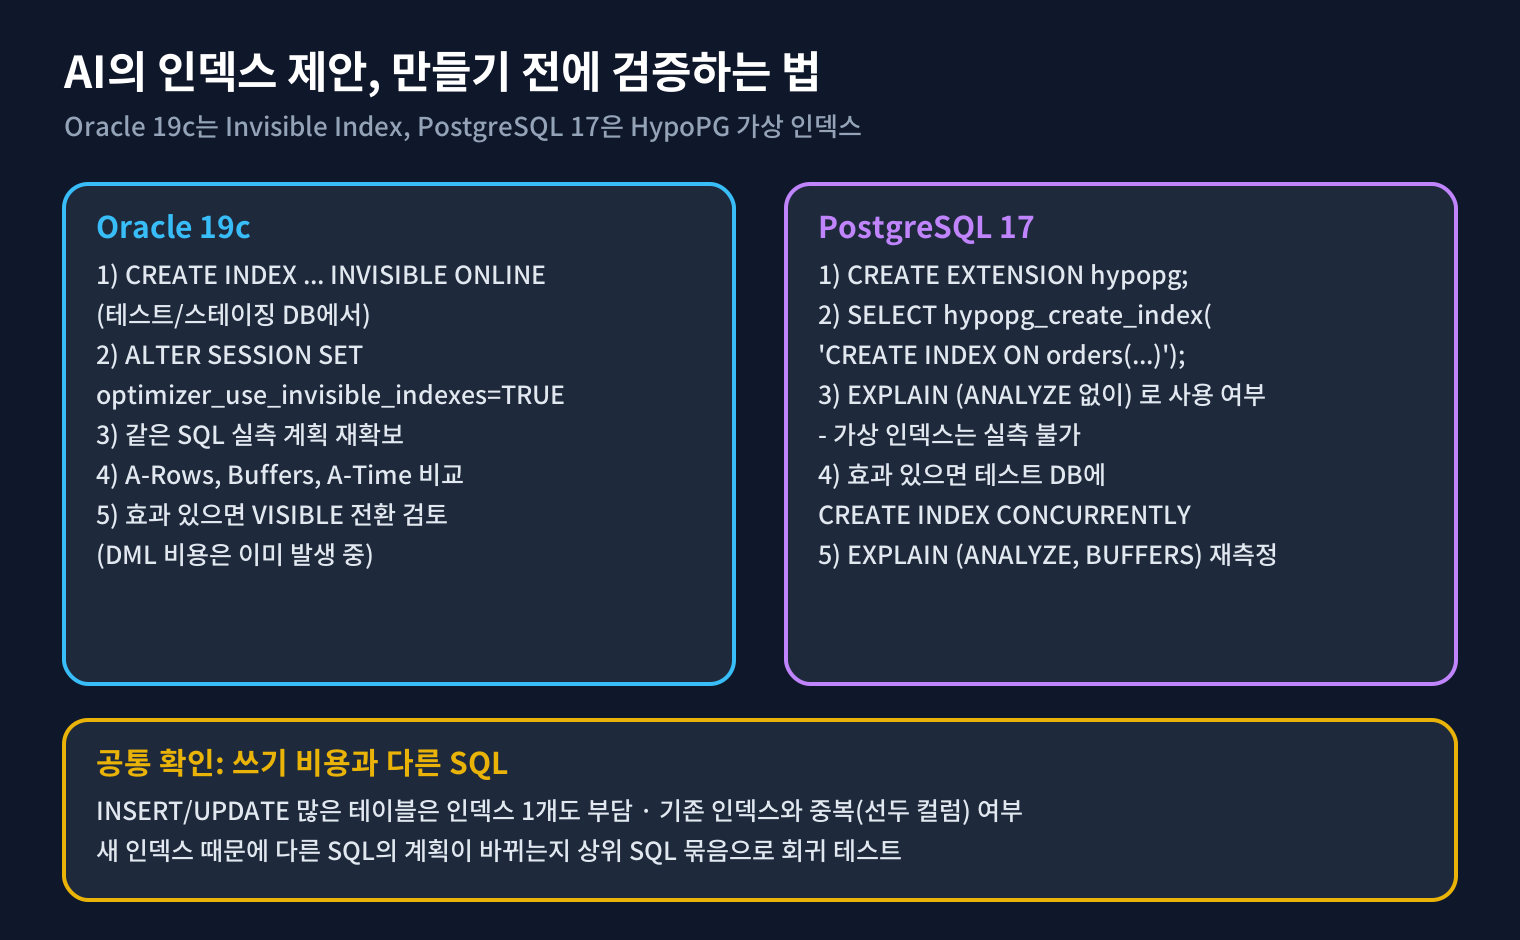
5. 인덱스 제안 검증: 만들기 전에 "보이지 않게" 시험합니다
올바른 순서는 SQL 재작성 → 실측 재확인 → 그래도 필요하면 인덱스 가설 검증입니다.
1단계 — 함수를 걷어낸 재작성 (Oracle 19c)
SELECT /*+ GATHER_PLAN_STATISTICS */
       c.cust_name, SUM(o.amount) AS total_amt
  FROM orders o
  JOIN customers c ON c.cust_id = o.cust_id
 WHERE o.order_dt >= TO_DATE(:from_dt, 'YYYYMMDD')   -- 컬럼은 가공하지 않음
   AND o.status   = :status
 GROUP BY c.cust_name;
2단계 — 통계 갱신 여부 검토
-- 테스트 환경에서 먼저. 운영은 통계 수집 정책·작업 시간 협의 후
BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(
    ownname    => 'APP',
    tabname    => 'ORDERS',
    method_opt => 'FOR ALL COLUMNS SIZE AUTO');
END;
/
3단계 — Invisible Index로 인덱스 가설 검증 (Oracle 19c, 테스트/스테이징 DB)
CREATE INDEX ix_orders_status_dt ON orders(status, order_dt) INVISIBLE ONLINE;

-- 이 세션에서만 옵티마이저가 Invisible Index를 고려
ALTER SESSION SET optimizer_use_invisible_indexes = TRUE;

-- 재작성한 SQL을 다시 실행하고 ALLSTATS LAST로 A-Rows·Buffers·A-Time 비교
SELECT * FROM TABLE(DBMS_XPLAN.DISPLAY_CURSOR(NULL, NULL, 'ALLSTATS LAST'));

ALTER SESSION SET optimizer_use_invisible_indexes = FALSE;
Invisible Index는 옵티마이저가 기본적으로 무시하지만, DML 시 유지 관리는 계속 됩니다. 즉 "보이지 않을 뿐 쓰기 비용은 이미 발생 중"이라는 점을 기억해야 합니다.
PostgreSQL 17 — HypoPG 가상 인덱스
CREATE EXTENSION IF NOT EXISTS hypopg;

SELECT * FROM hypopg_create_index(
  'CREATE INDEX ON orders (status, order_dt)');

-- 가상 인덱스는 실제로 존재하지 않으므로 ANALYZE 없이 EXPLAIN으로만 사용 여부 확인
EXPLAIN
SELECT c.cust_name, SUM(o.amount)
  FROM orders o JOIN customers c ON c.cust_id = o.cust_id
 WHERE o.order_dt >= DATE '2026-11-01'
   AND o.status = 'PENDING'
 GROUP BY c.cust_name;

SELECT hypopg_reset();   -- 가상 인덱스 제거

-- 효과가 보이면 테스트 DB에 실제 생성 후 실측
CREATE INDEX CONCURRENTLY ix_orders_status_dt ON orders (status, order_dt);
| 검증 도구 | 장점 | 한계 |
| Oracle Invisible Index | 실제 인덱스라 실측(A-Rows, A-Time) 가능 | 생성 비용·공간·DML 비용 발생 |
| PostgreSQL HypoPG | 디스크·CPU 비용 없이 즉시 확인 | 계획 선택 여부만 확인, 실측 불가 |
| AI 분석 | 빠른 원인 정리, 후보 나열 | 근거 없는 제안·틀린 해석 가능 |
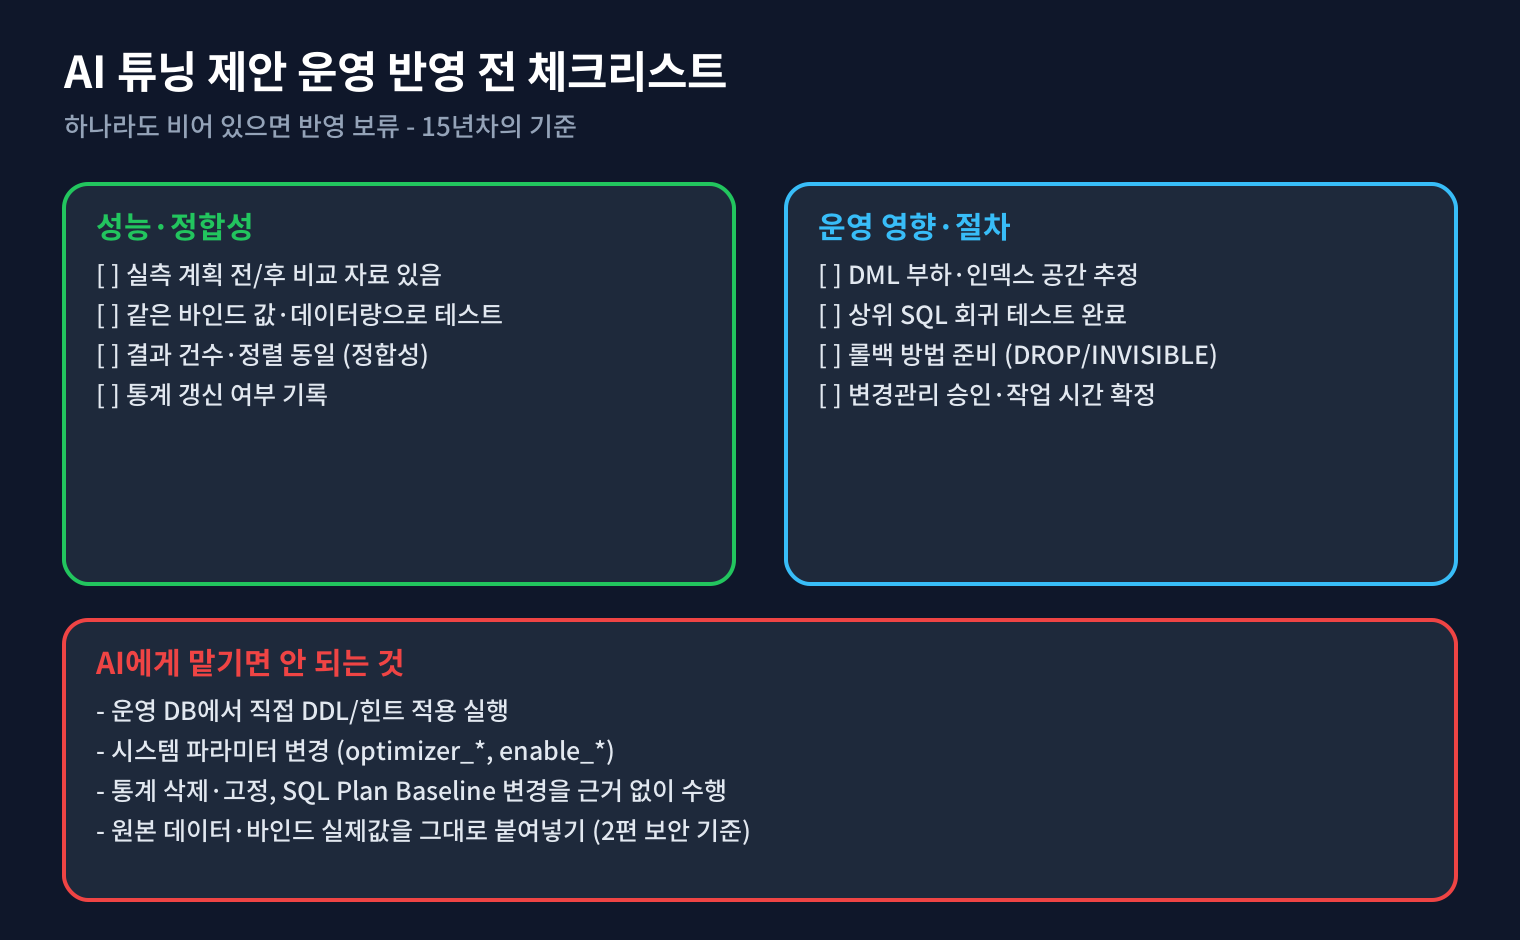
6. 운영 반영 전 체크리스트
AI가 아무리 정확해 보여도, 운영 반영 여부는 아래 체크리스트로 판단합니다. 하나라도 비어 있으면 반영을 보류합니다.
| 영역 | 확인 항목 |
| 성능 | 실측 계획 전/후 비교 자료(A-Rows, Buffers, 시간) |
| 정합성 | 재작성 전/후 결과 건수·합계·정렬 동일 여부 |
| 조건 | 운영과 같은 바인드 값·데이터량으로 테스트했는가 |
| 영향 | DML 부하, 인덱스 공간, 기존 인덱스와 선두 컬럼 중복 |
| 회귀 | 상위 SQL 묶음에서 다른 SQL의 계획이 바뀌지 않는가 |
| 절차 | 롤백 방법(DROP/INVISIBLE), 변경관리 승인, 작업 시간 |
그리고 AI에게 절대 맡기지 않는 것도 정해 두었습니다.
- 운영 DB에서 DDL·힌트 적용을 직접 실행하게 하는 것 (Cline 같은 에이전트 도구에 DB 접속을 열어두는 경우 특히 주의)
- optimizer_*, enable_* 같은 시스템 파라미터 변경
- 근거 없는 통계 삭제·고정, SQL Plan Baseline 변경
[내부 링크: Cline/VS Code 시리즈 — 에이전트 권한·승인 설정 편]
마치며
핵심 3줄
- AI에게는 반드시 실측 실행계획 + DDL + 통계·분포 정보를 함께 주고, 근거 Id 번호를 요구합니다.
- AI는 E-Rows/A-Rows 괴리 찾기는 잘하지만, Cost 맹신·loops 계산·운영 파라미터 변경 같은 지점에서 자주 틀립니다.
- 인덱스 제안은 SQL 재작성 → Invisible Index/HypoPG 검증 → 체크리스트 순서로 걸러냅니다.
다음 편 예고 — 5편 **「AI가 짜준 SQL, 운영 DB에 그냥 써도 될까」**에서는 AI가 작성한 SQL을 운영에 넣기 전 검증 절차와, 실제로 AI가 틀린 SQL 사례를 정리합니다. 결과는 맞는데 NULL 처리가 달라 건수가 어긋나는 경우처럼, 실행계획보다 더 찾기 어려운 함정들입니다.
이 글이 도움이 되셨다면 공감과 구독 부탁드립니다.