AI에게 내 DB 구조를 이해시키는 법 — 15년차 DBA가 정리한 스키마 컨텍스트 3층 구조 (Oracle 19c · PostgreSQL 17)
3줄 요약
AI가 SQL을 엉뚱하게 짜는 가장 큰 이유는 "모델이 멍청해서"가 아니라 내 DB 구조를 모르기 때문입니다.
- 스키마는 요약(항상) → 다이어트 DDL(필요할 때) → 업무 규칙(사람이 직접) 3층으로 나눠서 주면 됩니다.
- 컨텍스트 창이 100만 토큰이어도 많이 넣을수록 정확해지지 않습니다. 고르는 능력이 DBA의 몫입니다.
들어가며
AI × DBA 시리즈 2편 「DB 접속 정보를 AI에게 줘도 될까 — 보안 기준 정리」에서 "무엇을 AI에게 주면 안 되는가"를 정리했습니다. 이번 3편은 그 반대편 이야기입니다. 무엇을, 어떤 모양으로 주면 AI가 내 DB를 제대로 이해하는가.
AI에게 "최근 3개월 VIP 고객별 주문 금액 합계 SQL 짜줘"라고만 던지면, 대부분 이런 SQL이 돌아옵니다.
-- AI가 컨텍스트 없이 짠 SQL (그럴듯하지만 전부 추측)
SELECT c.customer_name, SUM(o.amount)
FROM   customers c
JOIN   orders o ON c.id = o.customer_id
WHERE  c.grade = 'VIP'
AND    o.order_date >= ADD_MONTHS(SYSDATE, -3)
GROUP  BY c.customer_name;
테이블명(customers), 컬럼명(id, amount, grade), 등급 코드('VIP')가 전부 지어낸 이름입니다. 문법은 완벽하니 더 위험합니다. 실제 우리 DB는 CUSTOMER.CUST_ID, ORDERS.TOTAL_AMT, 등급은 GRADE_CD = '03'이고, 취소 주문(STATUS_CD = '90')과 삭제 플래그(DEL_YN = 'Y')를 빼야 매출이 맞습니다.
이 글에서는 15년 동안 운영 DB를 만지며 정리한 방식으로, AI에게 스키마를 전달하는 구조·추출 SQL·프롬프트 템플릿·검증 절차를 순서대로 보여드리겠습니다. 예시는 모두 가상의 쇼핑몰 스키마(SHOP)입니다.
1. 컨텍스트 3층 구조 — 무엇을 줄 것인가
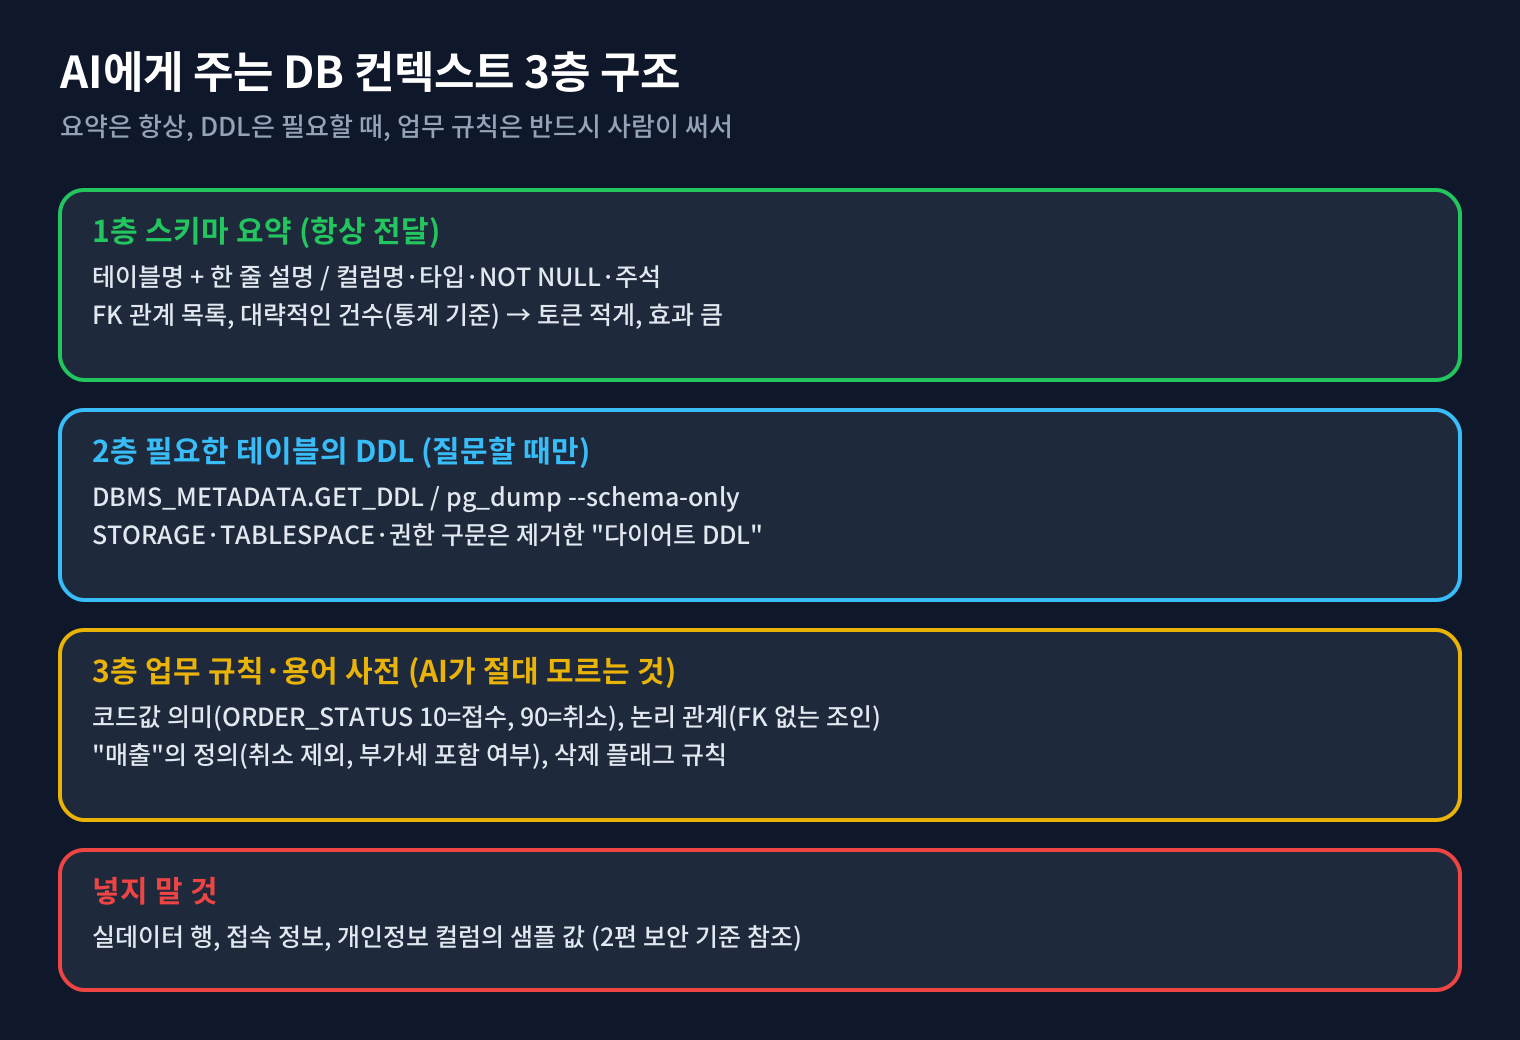
| 층 | 내용 | 전달 시점 | AI가 스스로 알 수 있나 |
| 1층 스키마 요약 | 테이블·컬럼·타입·NOT NULL·주석·FK·대략 건수 | 항상 | △ (메타데이터에서 추출 가능) |
| 2층 다이어트 DDL | 질문 대상 테이블의 PK·인덱스·파티션 | 튜닝·변경 질문 때 | △ |
| 3층 업무 규칙 | 코드값 의미, FK 없는 논리 관계, 용어 정의 | 반드시 | ✕ (사람만 앎) |
핵심은 3층입니다. 1·2층은 딕셔너리 뷰에서 뽑으면 되지만, "매출은 부가세 포함이고 취소·반품은 빼고, 테스트 고객(CUST_ID < 1000)도 빼야 한다" 같은 규칙은 DB 어디에도 없습니다. AI가 가장 많이 틀리는 지점도 여기입니다.
2. 추출 순서 — 어떤 순서로 준비할 것인가
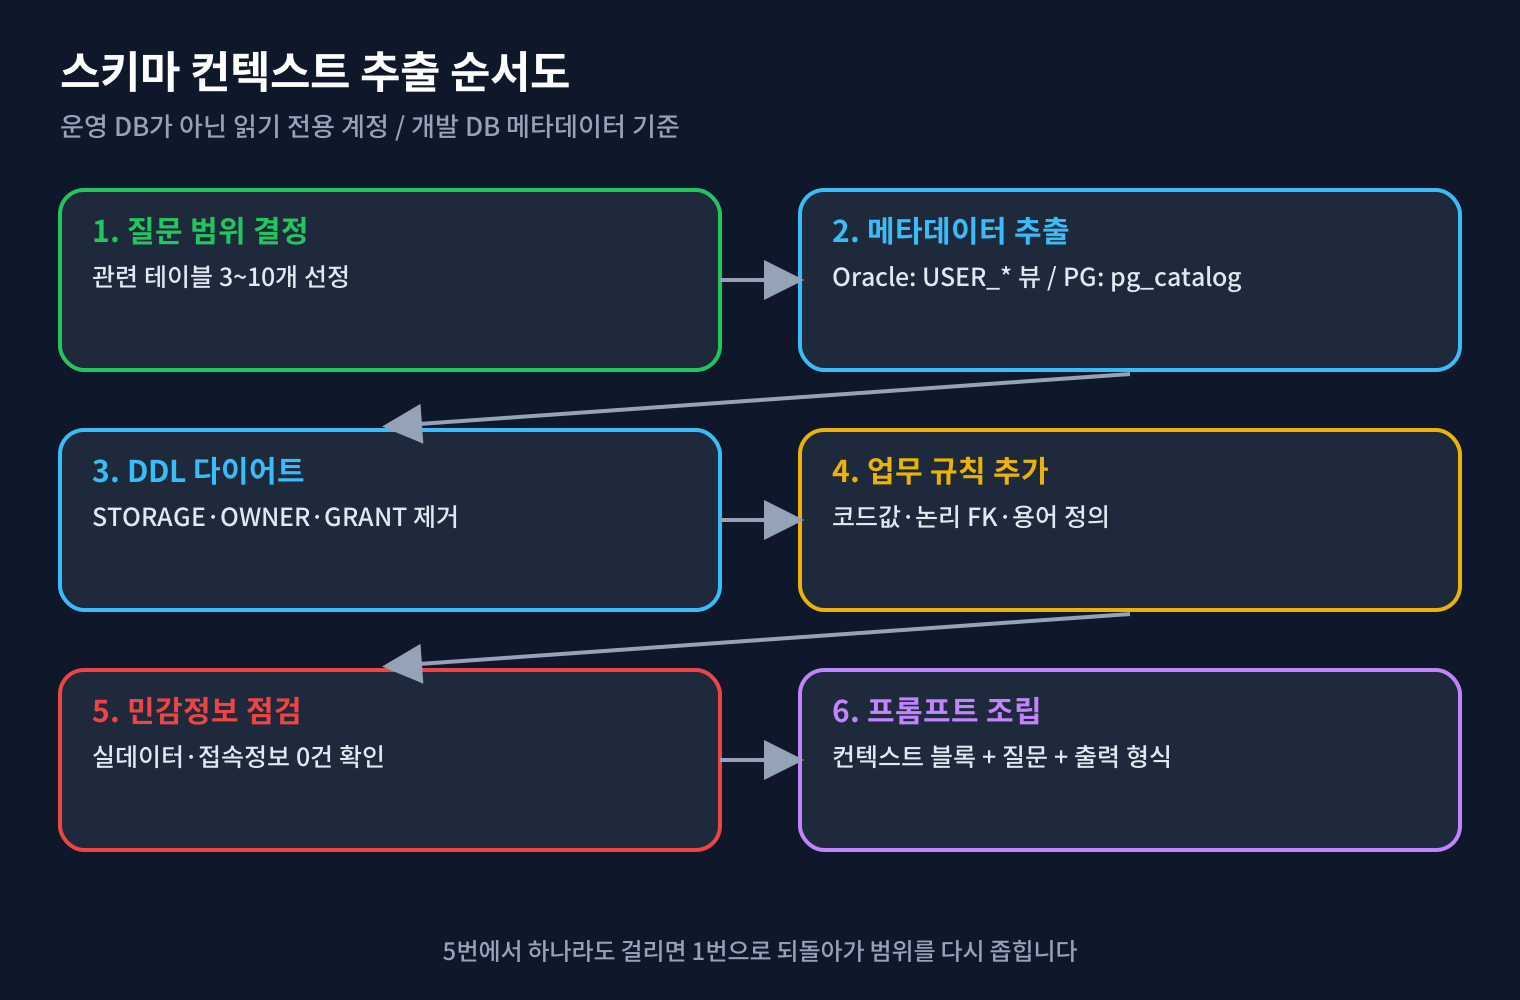
- 질문 범위 결정: 스키마 전체가 아니라 관련 테이블 3~10개만 고릅니다.
- 메타데이터 추출: 운영이 아닌 개발 DB, 읽기 전용 계정에서 딕셔너리 뷰만 조회합니다.
- DDL 다이어트: 물리 저장 속성을 걷어냅니다.
- 업무 규칙 추가: 코드값·논리 관계를 텍스트로 적습니다.
- 민감정보 점검: 실데이터 행, 접속 정보, 개인정보 샘플 값이 0건인지 확인합니다. (2편 기준)
- 프롬프트 조립: 아래 4장의 템플릿에 끼워 넣습니다.
3. Oracle 19c — 스키마 요약과 다이어트 DDL 뽑기
3-1. 1층: 테이블·컬럼 요약 (한 테이블당 한 덩어리)
-- Oracle 19c: 테이블별 컬럼 요약 (주석 포함)
SELECT t.table_name || ' -- ' || NVL(tc.comments, '(설명 없음)')
       || ' / 약 ' || NVL(t.num_rows, 0) || '건' || CHR(10) ||
       LISTAGG('  ' || c.column_name || ' ' || c.data_type ||
               CASE
                 WHEN c.data_type IN ('VARCHAR2','CHAR') THEN '(' || c.char_length || ')'
                 WHEN c.data_type = 'NUMBER' AND c.data_precision IS NOT NULL
                      THEN '(' || c.data_precision || ',' || c.data_scale || ')'
               END ||
               DECODE(c.nullable, 'N', ' NOT NULL') ||
               NVL2(cc.comments, ' -- ' || cc.comments, NULL),
               CHR(10) ON OVERFLOW TRUNCATE)
       WITHIN GROUP (ORDER BY c.column_id) AS summary
FROM   user_tables t
JOIN   user_tab_columns  c  ON c.table_name = t.table_name
LEFT   JOIN user_tab_comments tc ON tc.table_name = t.table_name
LEFT   JOIN user_col_comments cc ON cc.table_name = c.table_name
                               AND cc.column_name = c.column_name
WHERE  t.table_name IN ('CUSTOMER', 'ORDERS', 'ORDER_ITEM', 'PRODUCT')
GROUP  BY t.table_name, tc.comments, t.num_rows
ORDER  BY t.table_name;
- num_rows는 통계 기준 값입니다. 통계가 오래됐으면 실제와 다르니, AI에게도 "통계 기준 대략치"라고 명시해야 4편(실행계획)에서 엉뚱한 판단을 안 합니다.
- 컬럼이 많으면 LISTAGG가 4000바이트를 넘으므로 19c(12.2 이상)에서 쓸 수 있는 ON OVERFLOW TRUNCATE를 붙였습니다.
3-2. 1층: FK 관계 목록
-- FK 관계를 "자식.컬럼 -> 부모.컬럼" 한 줄로
SELECT a.table_name || '.' || ac.column_name || ' -> ' ||
       r.table_name || '.' || rc.column_name AS fk_relation
FROM   user_constraints  a
JOIN   user_cons_columns ac ON ac.constraint_name = a.constraint_name
JOIN   user_constraints  r  ON r.constraint_name  = a.r_constraint_name
JOIN   user_cons_columns rc ON rc.constraint_name = r.constraint_name
                           AND rc.position = ac.position
WHERE  a.constraint_type = 'R'
ORDER  BY 1;
운영 DB는 성능 이유로 FK를 안 거는 경우가 많습니다. 그러면 이 쿼리 결과가 비어 있고, AI는 컬럼명이 비슷한 것끼리 추측 조인을 합니다. 이건 3층(업무 규칙)에 "논리 FK"로 직접 적어줘야 합니다.
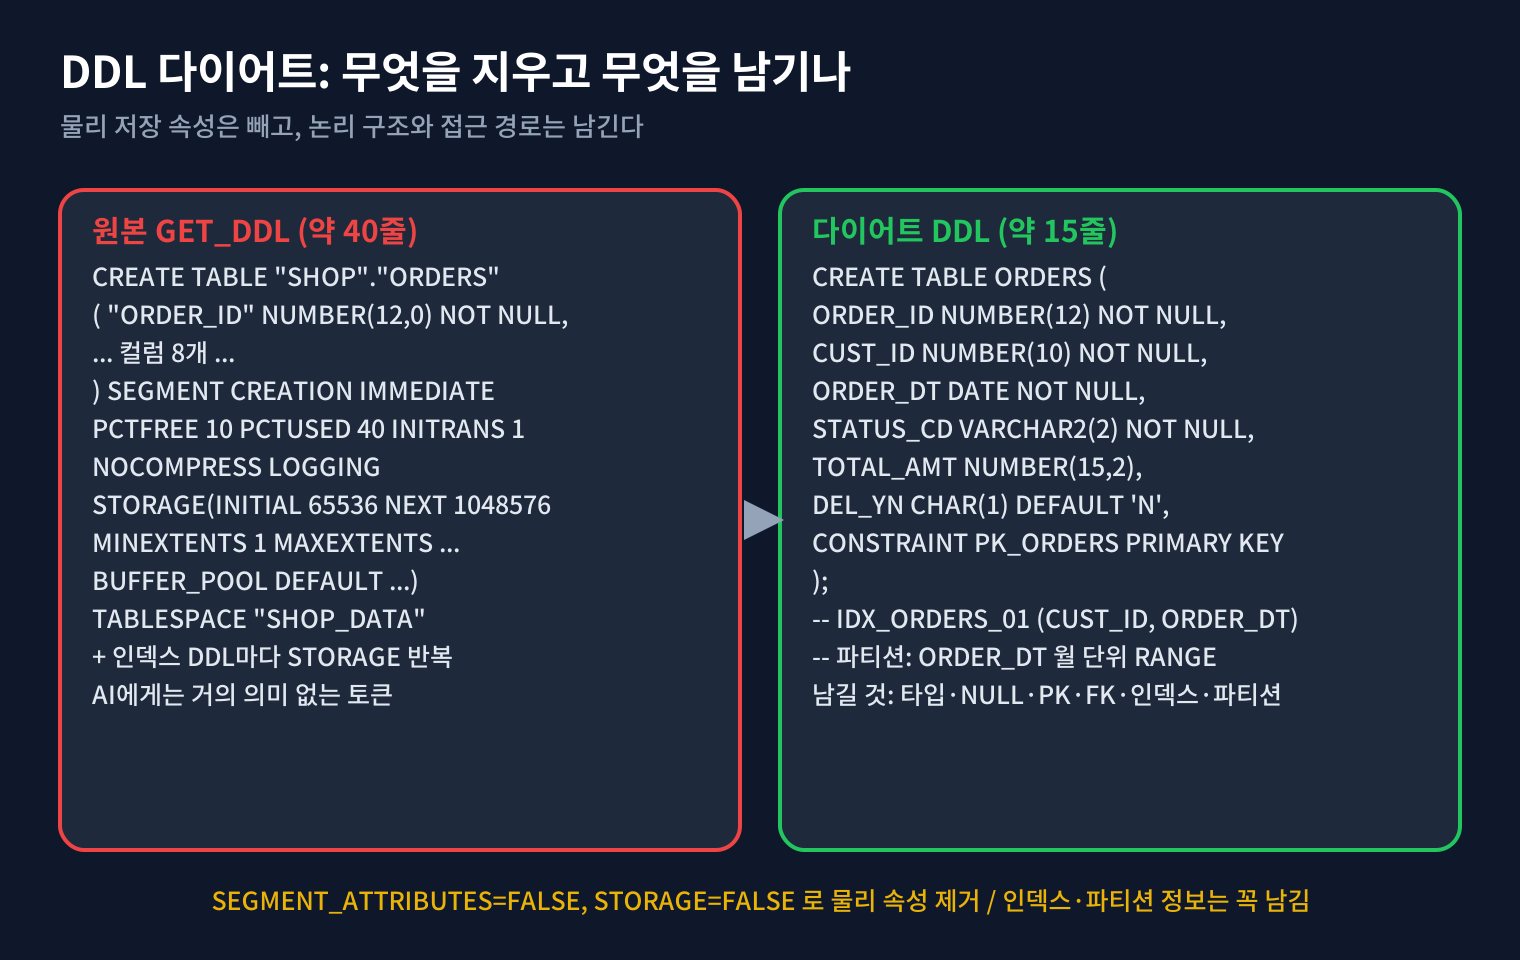
3-3. 2층: 다이어트 DDL
-- SQL*Plus / SQLcl
SET LONG 200000 LONGCHUNKSIZE 200000 PAGESIZE 0 LINESIZE 200

BEGIN
  DBMS_METADATA.SET_TRANSFORM_PARAM(DBMS_METADATA.SESSION_TRANSFORM, 'STORAGE',            FALSE);
  DBMS_METADATA.SET_TRANSFORM_PARAM(DBMS_METADATA.SESSION_TRANSFORM, 'SEGMENT_ATTRIBUTES', FALSE);
  DBMS_METADATA.SET_TRANSFORM_PARAM(DBMS_METADATA.SESSION_TRANSFORM, 'SQLTERMINATOR',      TRUE);
END;
/

SELECT DBMS_METADATA.GET_DDL('TABLE', 'ORDERS') FROM dual;

-- 인덱스는 따로: 어떤 컬럼 조합에 인덱스가 있는지가 튜닝 질문의 핵심
SELECT DBMS_METADATA.GET_DEPENDENT_DDL('INDEX', 'ORDERS') FROM dual;
SEGMENT_ATTRIBUTES = FALSE로 PCTFREE·TABLESPACE·LOGGING 같은 물리 속성이 빠지고, STORAGE = FALSE로 STORAGE 절이 빠집니다. 인덱스·파티션 정보는 반드시 남깁니다. 이게 없으면 AI는 "CUST_ID에 인덱스를 만드세요"처럼 이미 있는 인덱스를 또 제안합니다.
4. PostgreSQL 17 — 같은 작업을 PG에서
4-1. 다이어트 DDL: pg_dump
# 스키마만, 소유자·권한 구문 제외, 필요한 테이블만
pg_dump -h devdb -U ro_meta -d shopdb \
        --schema-only --no-owner --no-privileges \
        -t 'shop.customer' -t 'shop.orders' -t 'shop.order_item' \
        > shop_context_ddl.sql
--no-owner, --no-privileges로 ALTER ... OWNER TO, GRANT 구문이 빠집니다. 계정명이 노출되지 않으니 보안상으로도 낫습니다.
[내부 링크: PostgreSQL 시리즈 — pg_dump 백업·복구 편]
4-2. 1층 요약: pg_catalog 쿼리
-- PostgreSQL 17: 테이블별 컬럼 요약 (주석 + 통계 기준 건수)
SELECT c.relname || ' -- ' || coalesce(obj_description(c.oid, 'pg_class'), '(설명 없음)')
       || ' / 약 ' || greatest(c.reltuples, 0)::bigint || '건' || E'\n' ||
       string_agg('  ' || a.attname || ' ' || format_type(a.atttypid, a.atttypmod)
                  || CASE WHEN a.attnotnull THEN ' NOT NULL' ELSE '' END
                  || coalesce(' -- ' || col_description(c.oid, a.attnum), ''),
                  E'\n' ORDER BY a.attnum) AS summary
FROM   pg_class c
JOIN   pg_namespace n ON n.oid = c.relnamespace
JOIN   pg_attribute a ON a.attrelid = c.oid AND a.attnum > 0 AND NOT a.attisdropped
WHERE  n.nspname = 'shop'
AND    c.relkind IN ('r', 'p')          -- 일반 테이블 + 파티션 부모
GROUP  BY c.oid, c.relname, c.reltuples
ORDER  BY c.relname;
PG에서 reltuples는 한 번도 ANALYZE 안 된 테이블이면 -1이 나오므로 greatest(..., 0)로 감쌌습니다. Oracle에서 넘어온 분들이 자주 헷갈리는 대소문자 식별자("OrderId"처럼 따옴표로 만든 컬럼)도 이 결과에 그대로 드러나니, AI에게 "따옴표 식별자 있음"을 꼭 알려주세요.
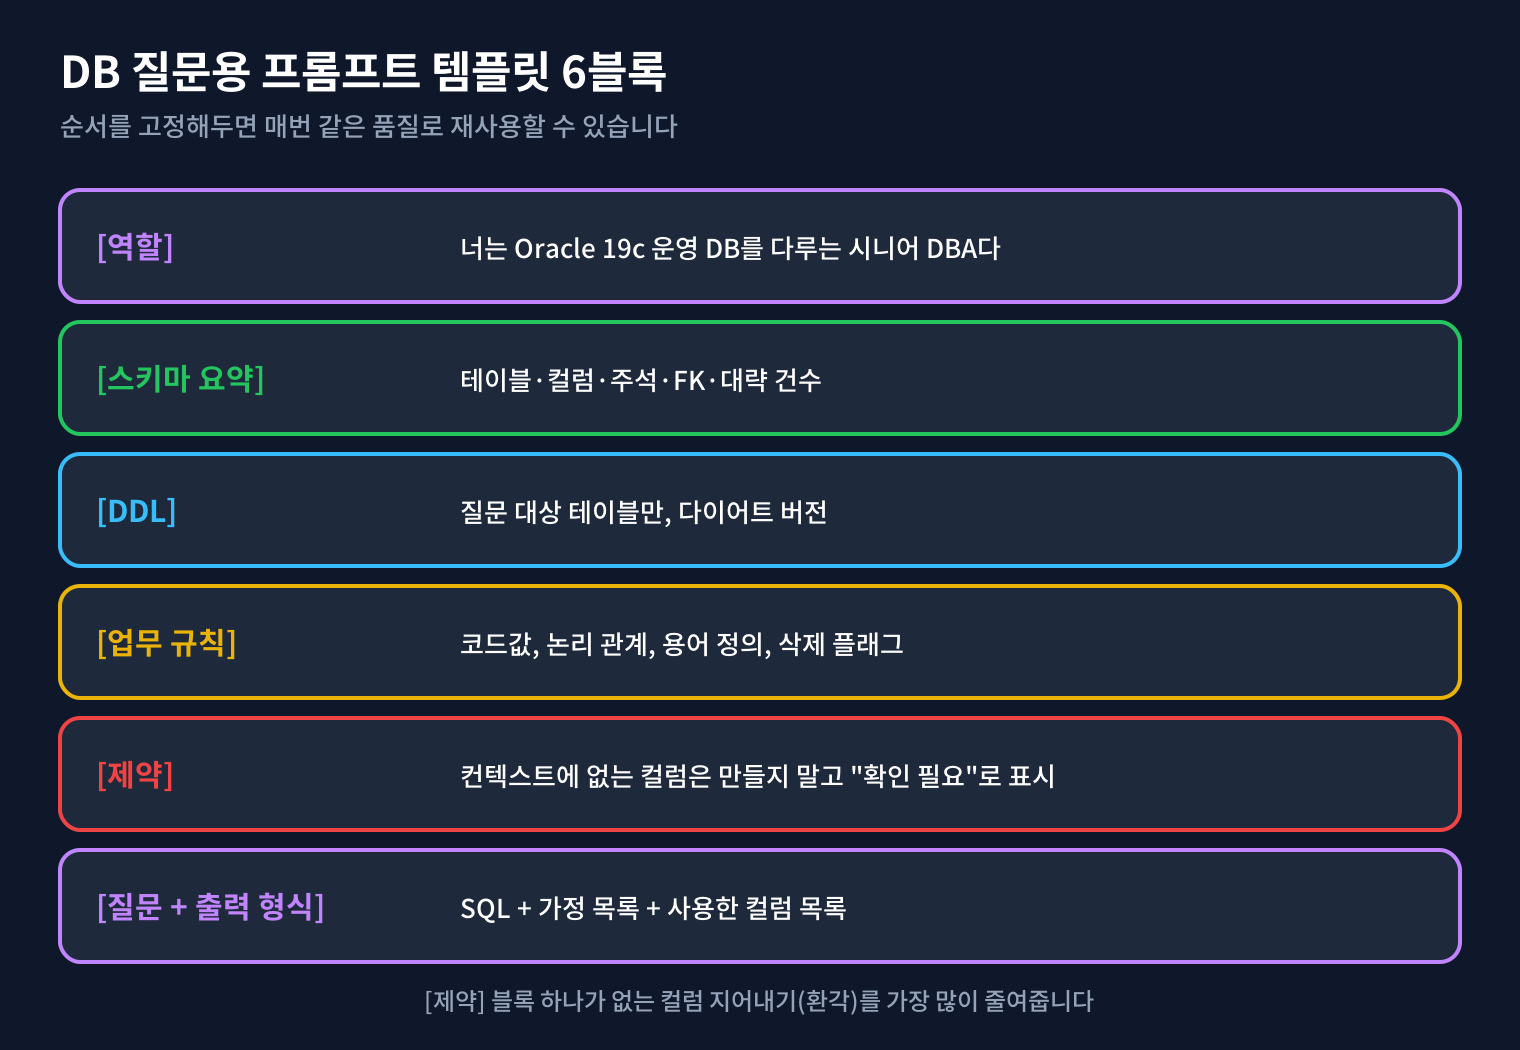
5. 프롬프트 템플릿 — 어떤 모양으로 줄 것인가
[역할]
너는 Oracle 19c 운영 DB를 다루는 시니어 DBA다.

[스키마 요약]
CUSTOMER -- 고객 마스터 / 약 120만건
  CUST_ID NUMBER(10,0) NOT NULL -- 고객번호(PK)
  GRADE_CD VARCHAR2(2) NOT NULL -- 등급코드
  DEL_YN CHAR(1) NOT NULL -- 탈퇴 여부
ORDERS -- 주문 헤더 / 약 3,400만건, ORDER_DT 월 단위 RANGE 파티션
  ORDER_ID NUMBER(12,0) NOT NULL
  CUST_ID NUMBER(10,0) NOT NULL
  ORDER_DT DATE NOT NULL
  STATUS_CD VARCHAR2(2) NOT NULL
  TOTAL_AMT NUMBER(15,2) -- 부가세 포함 결제금액
FK: ORDERS.CUST_ID -> CUSTOMER.CUST_ID (논리 FK, 제약조건 없음)
인덱스: IDX_ORDERS_01 (CUST_ID, ORDER_DT)

[업무 규칙]
- GRADE_CD: 01=일반, 02=우수, 03=VIP
- STATUS_CD: 10=접수, 20=결제완료, 30=배송중, 40=배송완료, 90=취소
- 매출 = STATUS_CD IN ('20','30','40') 의 TOTAL_AMT 합계
- DEL_YN = 'Y' 고객, CUST_ID < 1000(테스트 계정)은 항상 제외

[제약]
- 위 컨텍스트에 없는 테이블·컬럼은 절대 만들지 말 것.
  필요하면 "확인 필요: ○○"라고 적을 것.
- 파티션 키(ORDER_DT) 조건이 빠지지 않게 할 것.

[질문]
최근 3개월 VIP 고객별 매출 합계 상위 100명.

[출력 형식]
1) SQL  2) 사용한 컬럼 목록  3) 내가 세운 가정 목록
이 템플릿으로 다시 물으면 AI는 GRADE_CD = '03', STATUS_CD IN ('20','30','40'), DEL_YN = 'N', CUST_ID >= 1000, ORDER_DT 범위 조건을 갖춘 SQL을 돌려줍니다. 그래도 3장 "가정 목록"을 반드시 읽어야 합니다. "3개월을 오늘 기준 90일로 해석했다" 같은 해석 차이가 여기서 드러납니다.
[내부 링크: Claude 시리즈 — 프로젝트 지식(Project Knowledge)에 문서 올리기 편]
6. 많이 넣으면 좋을까? — 컨텍스트 창의 함정
요즘 Claude의 주요 모델(Opus·Sonnet 계열 최신 모델 등)은 공식 문서 기준으로 100만 토큰 컨텍스트 창을 기본 지원합니다. 스키마 전체 DDL을 통째로 넣어도 들어가긴 합니다.
하지만 같은 공식 문서는 토큰이 늘어날수록 정확도와 회상력이 떨어지는 현상(context rot)을 명시하고, "더 큰 창이 더 많은 컨텍스트가 낫다는 뜻은 아니다"라고 설명합니다. 현장 감각도 같습니다. 테이블 800개 DDL을 다 넣으면 이름이 비슷한 ORDER_HIST, ORDER_BAK_2023을 진짜 테이블과 섞어 씁니다.
| 상황 | 권장 컨텍스트 |
| 단순 조회 SQL 작성 | 1층 요약 + 3층 규칙 (관련 테이블만) |
| SQL 튜닝·실행계획 해석 | 1층 + 2층(인덱스·파티션) + 통계 시점 |
| DDL 변경·마이그레이션 검토 | 2층 전체 + 의존 객체(뷰·트리거) 목록 |
| 스키마 전체 문서화 | 테이블 단위로 쪼개서 여러 번 (7편에서 다룸) |
백업 테이블(*_BAK, *_OLD, TMP_*)은 추출 단계에서 WHERE table_name NOT LIKE '%BAK%' 식으로 반드시 걸러내세요. AI 입장에서는 진짜 테이블과 구분할 방법이 없습니다.
7. 전달 방식 3가지 — 선택지 비교
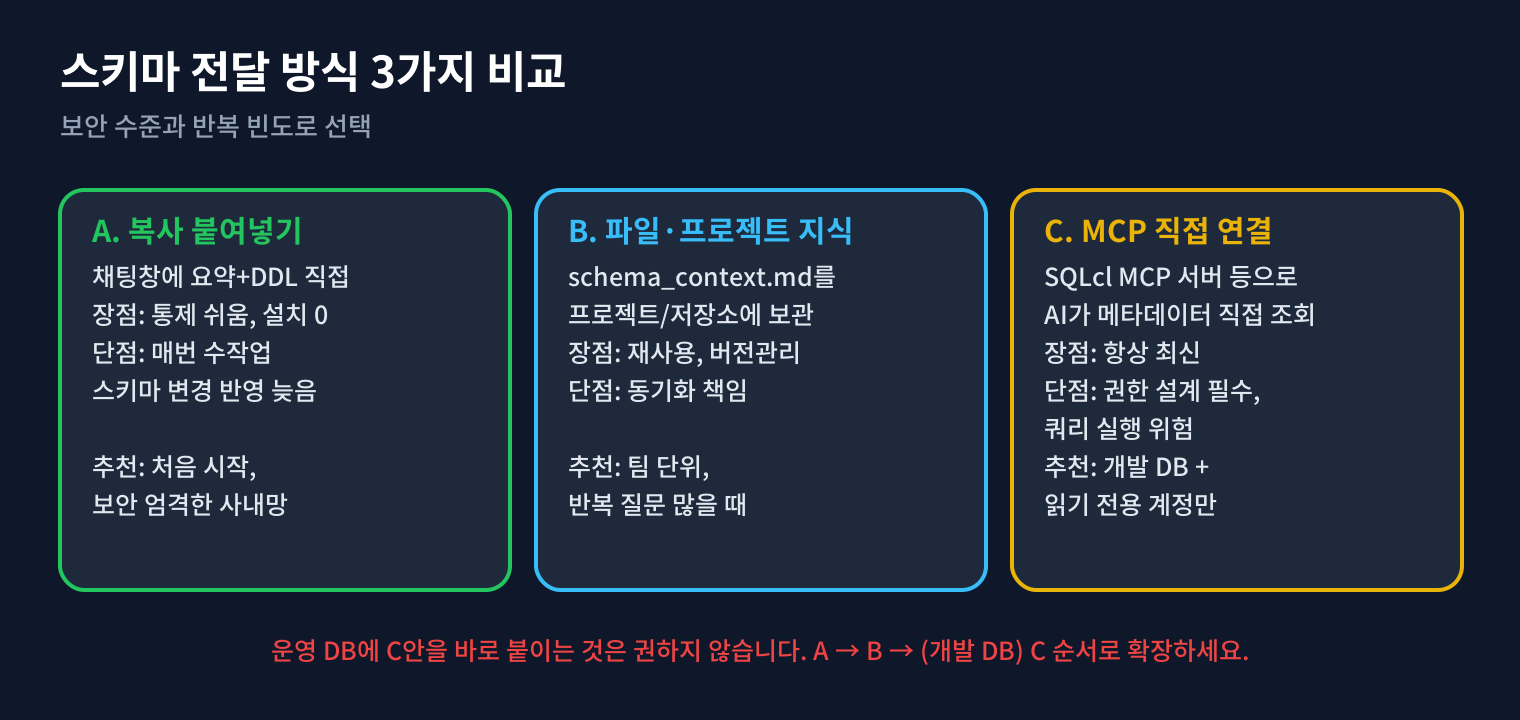
| 방식 | 장점 | 단점 | 이런 분께 추천 |
| A. 복사 붙여넣기 | 설치 0, 통제 쉬움 | 매번 수작업, 변경 반영 늦음 | 처음 시작, 보안이 엄격한 사내망 |
| B. 파일·프로젝트 지식 (schema_context.md) | 재사용, Git 버전관리 | 스키마 변경 시 동기화 책임 | 팀 단위, 반복 질문이 많을 때 |
| C. MCP로 DB 직접 연결 | 항상 최신 메타데이터 | 권한 설계 필수, 쿼리 실행 위험 | 개발 DB + 읽기 전용 계정 한정 |
C안의 대표 예가 Oracle의 SQLcl MCP 서버입니다. Oracle 블로그에 따르면 저장된 SQLcl 접속 정보를 이용해 list-connections, connect, disconnect, run-sql, run-sqlcl 같은 도구를 AI에게 제공하고, 19c부터 지원 버전에서 쓸 수 있습니다. Oracle 스스로도 최소 권한 원칙, AI 세션의 MODULE/ACTION 기록, 쿼리 실행 전 사람의 승인을 강조합니다.
제 결론은 이렇습니다. run-sql이 있다는 건 AI가 SELECT만 하리라는 보장이 없다는 뜻입니다. 운영 DB에는 붙이지 말고, 메타데이터 조회 권한만 준 전용 계정으로 개발 DB에서 시작하세요. 접속 설정은 [내부 링크: Cline/VS Code 시리즈 — MCP 서버 연결 편]을 참고하시면 됩니다.
추천 경로: A안으로 템플릿을 다듬기 → B안으로 schema_context.md를 Git에 보관 → 충분히 익숙해지면 개발 DB에 한해 C안.
8. AI가 그래도 틀리는 지점 — 검증 플로우
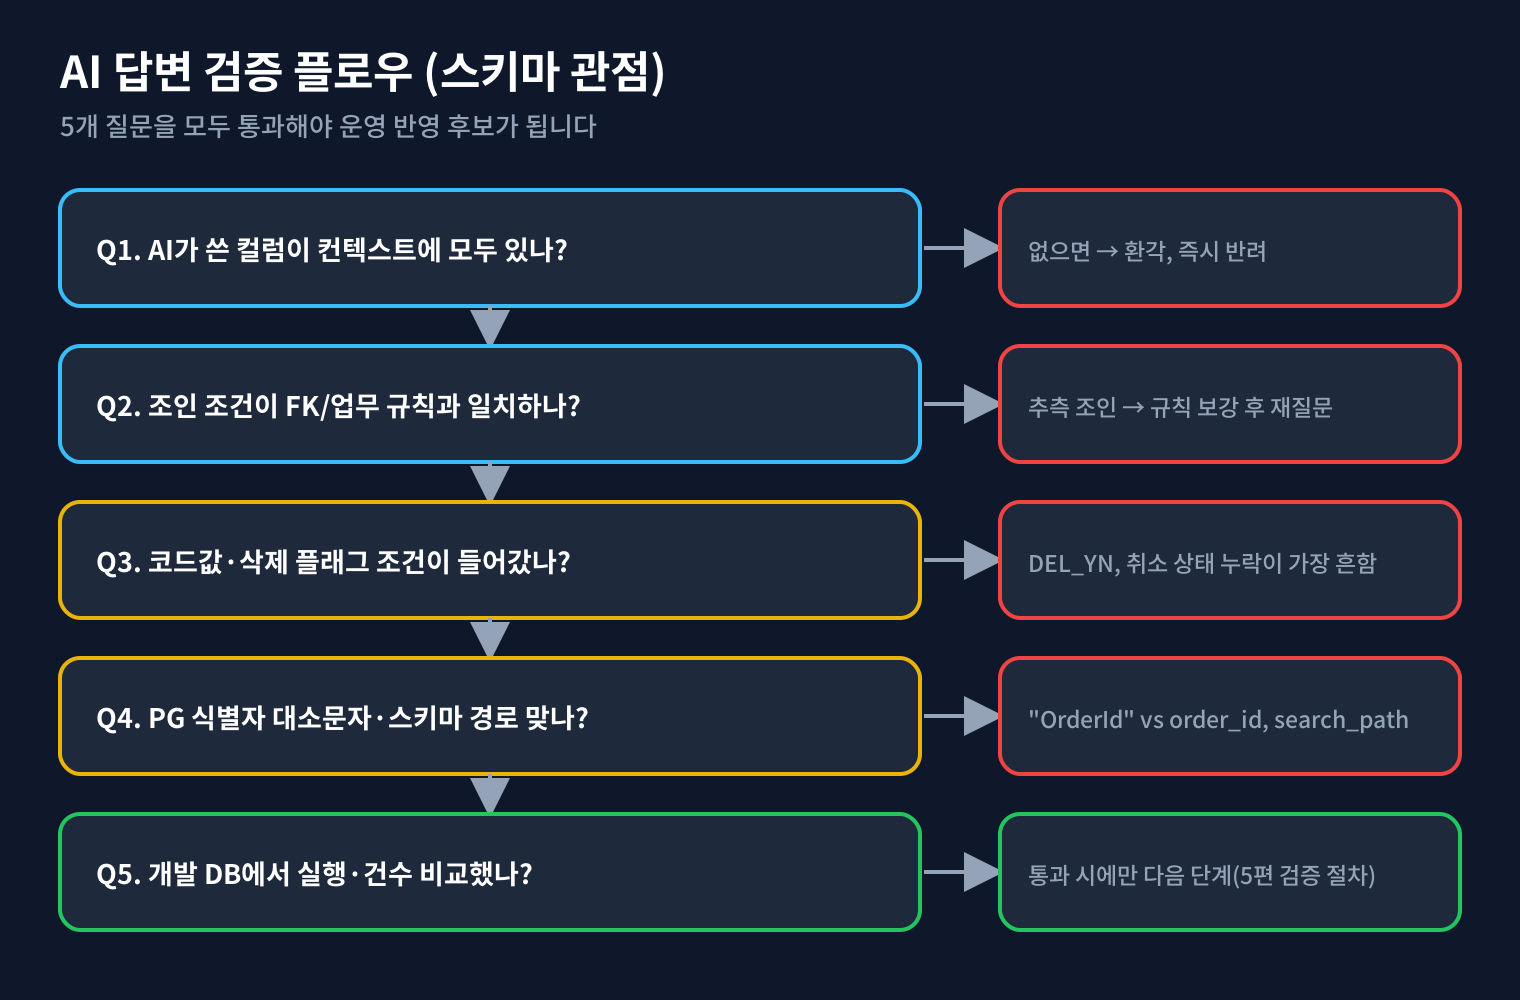
컨텍스트를 잘 줘도 AI는 틀립니다. 제가 실제로 가장 자주 보는 오류 유형을 정리하면 이렇습니다.
| 오류 유형 | 예시 | 잡는 방법 |
| 없는 컬럼 생성 | ORDERS.ORDER_AMT (실제는 TOTAL_AMT) | "사용한 컬럼 목록"을 딕셔너리와 대조 |
| 추측 조인 | ORDER_ITEM.PROD_NO = PRODUCT.PROD_ID로 타입 다른 컬럼 조인 | 논리 FK를 규칙에 명시 |
| 필터 누락 | DEL_YN, 취소 상태, 테스트 계정 조건 빠짐 | 업무 규칙을 [제약] 블록에 재강조 |
| 파티션 키 누락 | TRUNC(ORDER_DT)로 감싸서 파티션 프루닝 실패 | 실행계획 확인 (4편) |
| DB 방언 혼동 | PG에 NVL, ROWNUM 사용 | 역할 블록에 DB 버전 명시 |
| 대소문자 식별자 | PG "OrderId"를 orderid로 씀 | 요약에 따옴표 식별자 표시 |
컬럼 대조는 사람이 눈으로 하지 말고 쿼리로 하세요.
-- Oracle: AI가 "사용했다"고 한 컬럼 중 실제로 없는 것 찾기
WITH ai_cols (tname, cname) AS (
  SELECT 'ORDERS', 'ORDER_AMT' FROM dual UNION ALL
  SELECT 'ORDERS', 'TOTAL_AMT' FROM dual UNION ALL
  SELECT 'CUSTOMER', 'GRADE_CD' FROM dual
)
SELECT a.tname, a.cname AS missing_column
FROM   ai_cols a
LEFT   JOIN user_tab_columns c
       ON c.table_name = a.tname AND c.column_name = a.cname
WHERE  c.column_name IS NULL;
이 쿼리에서 한 줄이라도 나오면 그 SQL은 즉시 반려입니다. 통과한 SQL도 개발 DB에서 실행해 건수를 비교한 다음에야 운영 반영 후보가 됩니다. 운영 반영 전 전체 검증 절차는 5편에서 따로 다룹니다.
마치며
- AI가 SQL을 틀리는 1순위 원인은 컨텍스트 부족입니다. 요약·DDL·업무 규칙 3층으로 나눠 주세요.
- 업무 규칙(코드값, 논리 FK, 매출 정의)은 DB에 없습니다. 이건 DBA가 직접 써야 하는 자산입니다.
- 많이 넣는다고 정확해지지 않습니다. 관련 테이블만 고르고, "없는 컬럼은 만들지 마라" 제약과 컬럼 대조 쿼리로 검증하세요.
다음 편 예고: 4편 「느린 SQL, AI에게 실행계획을 읽혀봤다」에서는 오늘 만든 컨텍스트에 DBMS_XPLAN·EXPLAIN (ANALYZE, BUFFERS) 결과를 붙여서, AI의 인덱스 제안이 실제로 맞는지 검증해보겠습니다.
시리즈 처음부터 보시려면 AI × DBA 1편 「DBA가 AI를 쓰면 뭐가 달라지나 — 15년차의 솔직한 검증」부터 읽어주세요. 접속 오류로 막히셨다면 [내부 링크: ORA-12541 TNS 리스너 없음 해결 편]도 함께 참고하세요.
이 글이 도움이 되셨다면 공감과 구독 부탁드립니다.
'AI × DBA 시리즈' 카테고리의 다른 글
| DB 접속 정보를 AI에게 줘도 될까? 15년차 DBA가 정리한 AI 보안 기준 4등급 (민감정보·마스킹·반입 범위) (0) | 2026.11.02 |
|---|---|
| [AI × DBA 1편] DBA가 AI를 쓰면 뭐가 달라지나 — 15년차가 직접 검증해봤다 (AI DBA, DB 자동화) (0) | 2026.10.26 |